По данным разработчиков, решение позволяет увеличить число одновременно обслуживаемых пользователей в четыре раза без наращивания вычислительных мощностей GPU
«Тантор Лабс» и разработчик платформы «Боцман», входящие в «Группу Астра», представили программно-аппаратное решение для хранения кэша KV-cache больших языковых моделей. Технология позволяет переносить промежуточные данные из ограниченной видеопамяти GPU во внешние NVMe-накопители, снижая нагрузку на ускорители и повышая эффективность обработки запросов.
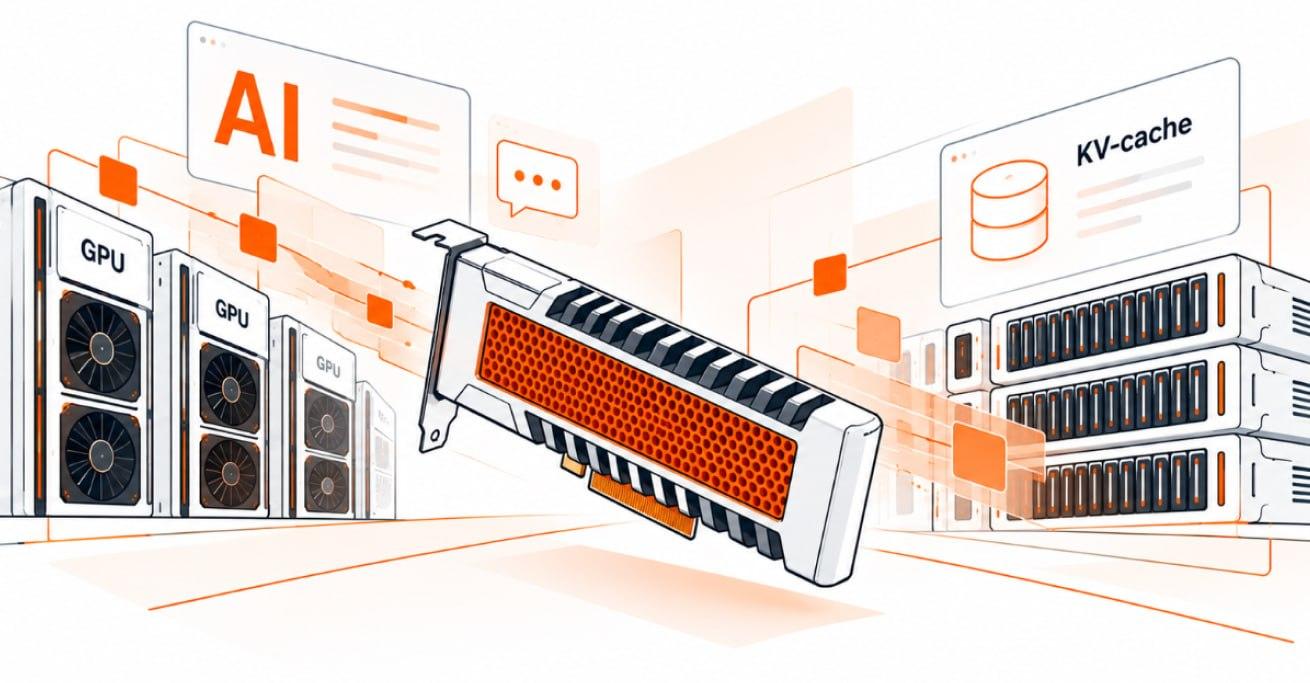
Решение Tantor Context Memory Storage использует специализированный аппаратный модуль для быстрого доступа к сохранённым данным. Это позволяет повторно применять результаты предыдущих вычислений, сокращать задержки и обслуживать больше пользователей без пропорционального увеличения числа GPU.
По данным разработчиков, испытания на одинаковых серверах и моделях показали, что новая технология позволяет увеличить число одновременно обслуживаемых клиентов в четыре раза при соблюдении заданных требований к задержке.
Решение поддерживает среды vLLM, LMCache и NVIDIA Dynamo, а также ускорители Nvidia, AMD и ряда китайских производителей. Доступ к контекстной памяти организован через NVMe-хранилище с использованием RDMA и сетевых адаптеров 400 GbE.
Управление технологией интегрировано в платформу «Боцман», которая обеспечивает развёртывание и масштабирование ИИ-моделей, распределение вычислительных ресурсов и мониторинг инфраструктуры. Совместная разработка предназначена для корпоративных ИИ-сервисов, которым необходимо увеличивать нагрузку без сопоставимого роста затрат на вычислительное оборудование.