Traducido con IA del original en ruso.
Según los desarrolladores, la solución permite cuadruplicar el número de usuarios atendidos simultáneamente sin aumentar la potencia de cálculo de la GPU
Tantor Labs y el desarrollador de la plataforma Botsman, que forman parte del Grupo Astra, presentaron una solución de hardware y software para almacenar el caché KV-cache de grandes modelos de lenguaje. La tecnología permite transferir datos intermedios de la memoria de video limitada de la GPU a unidades NVMe externas, reduciendo la carga sobre los aceleradores y aumentando la eficiencia del procesamiento de solicitudes.
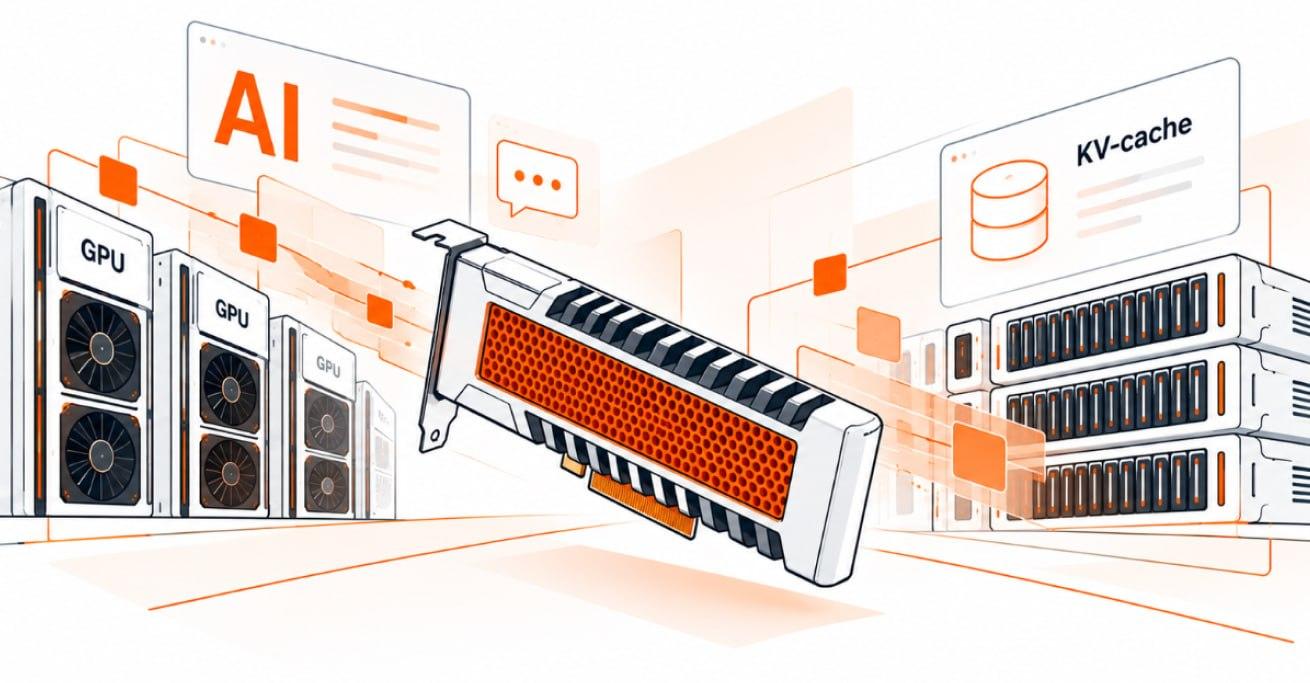
La solución Tantor Context Memory Storage utiliza un módulo de hardware especializado para un acceso rápido a los datos guardados. Esto permite reutilizar los resultados de cálculos anteriores, reducir las latencias y atender a más usuarios sin un aumento proporcional en el número de GPU.
Según los desarrolladores, las pruebas en los mismos servidores y modelos mostraron que la nueva tecnología permite cuadruplicar el número de clientes atendidos simultáneamente, cumpliendo con los requisitos de latencia establecidos.
La solución es compatible con los entornos vLLM, LMCache y NVIDIA Dynamo, así como con aceleradores Nvidia, AMD y varios fabricantes chinos. El acceso a la memoria contextual se organiza a través del almacenamiento NVMe utilizando RDMA y adaptadores de red de 400 GbE.
La gestión de la tecnología está integrada en la plataforma Botsman, que proporciona el despliegue y la escalabilidad de los modelos de IA, la distribución de los recursos informáticos y la monitorización de la infraestructura. El desarrollo conjunto está diseñado para servicios de IA corporativos que necesitan aumentar la carga sin un crecimiento comparable en los costos de hardware informático.